لماذا نرفض اعتبار الذكاء الاصطناعي واعيًا حتى عندما يتصرف مثل الإنسان؟
خمس تجارب على 1,092 مشاركًا تكشف لماذا ننسب وعيًا أكبر للبشر من الذكاء الاصطناعي رغم السلوك المتشابه، وكيف يغير الفرق بين الوعي والإدراك أحكامنا.
محتويات المقال
- خلاصة النتائج: ماذا حدث في الدراسة؟
- كيف اختبر الباحثون الوعي من دون أن يختبروا الآلات نفسها؟
- ثلاثة أبعاد للسلوك اختبرتها السيناريوهات
- ما الفرق الحقيقي بين الوعي والإدراك والذكاء؟
- لماذا أعطينا الإنسان أفضلية حتى مع تطابق السلوك؟
- هل الجوهرانية انحياز خاطئ دائمًا؟
- لماذا يمكن لكلمة واحدة أن تغيّر الحكم؟
- لماذا تختلف نتائج الألفاظ من لغة لأخرى؟
- هل اختبرت الدراسة ذكاءً اصطناعيًا واعيًا فعلًا؟
- كيف يبدو الجدل العلمي بشأن وعي الذكاء الاصطناعي في 2026؟
- ماذا عن اختبار تورينغ؟ إذا أقنعك النظام بأنه إنسان، ألا يكفي؟
- هل «التجربة الصينية» أو «غرفة صينية» تحسم القضية؟
- لماذا قد نتعامل عاطفيًا مع برنامج رغم أننا لا نعتقد أنه واعٍ؟
- أربع إشارات تسويقية تحتاج قراءة نقدية
- ما حدود هذه الدراسة؟ ولماذا ينبغي أن نذكرها؟
- أولًا: العينة بريطانية وليست عالمية
- ثانيًا: السيناريو المكتوب ليس محادثة واقعية
- ثالثًا: ألفاظ القياس تحمل معاني متعددة
- رابعًا: التسجيل المسبق يعزز الشفافية ولا يلغي القيود
- خامسًا: الدراسة لا تقيس الدماغ ولا الوعي الحقيقي للذكاء الاصطناعي
- تجربة فكرية: هل ستختلف إجابتك إذا تغيّر اسم الفاعل فقط؟
- كيف نقرأ أخبار «الذكاء الاصطناعي الواعي» من دون مبالغة أو إنكار؟
- ما الذي تضيفه الدراسة إلى فهمنا لأنفسنا؟
- الخلاصة: ليس كل ما يشبهنا يشعر مثلنا، لكن التشابه ليس حكمًا نهائيًا
- المصادر والدراسات التي بُني عليها المقال
صورة تعبيرية مولّدة فنيًا عن مواجهة الإنسان لروبوت متقدم؛ لا تمثل مشاركين في دراسة 2026 أو اختبارًا واقعيًا.
تخيّل أنك تقرأ قصة قصيرة عن شخص سمع صوت طفل يبكي في غرفة مجاورة، فالتفت ناحية الصوت، وتعرّف إلى سبب البكاء، ثم تصرّف بطريقة مناسبة للموقف. والآن تخيّل القصة نفسها، بكل تفاصيلها، لكن بطلها روبوت مزوّد بذكاء اصطناعي. هل ستمنح الاثنين الدرجة نفسها من «الوعي»؟ وهل ستتغير إجابتك إذا سُئلت عن «إدراكهما لما يحدث حولهما» بدلًا من الوعي؟
هذا الفرق اللغوي البسيط هو مفتاح دراسة نفسية نُشرت إلكترونيًا في 1 أكتوبر 2026 في مجلة Cognition. اختبر الباحثون كيف يحكم الناس على الحالات العقلية للبشر والأنظمة الاصطناعية، فوجدوا أنهم لا يعتمدون على جودة السلوك وحدها: عند الحديث عن الوعي (Consciousness) يُعطون الإنسان أفضلية كبيرة، حتى مع تقديم أوصاف سلوكية متماثلة؛ أما عند الحديث عن الإدراك أو الانتباه إلى المحيط (Awareness)، فتصبح أحكامهم أقرب إلى الاستناد إلى قدرة الكائن أو النظام على الاستجابة. الدراسة الأصلية في Cognition.
والنتيجة لا تقول إن الذكاء الاصطناعي واعٍ أو غير واعٍ. ما قاسه الباحثون هو اعتقاد البشر بشأن الوعي، لا وجود تجربة ذاتية داخل الآلة. لهذا يقدم البحث نافذة على سؤالين مختلفين تمامًا: كيف ننظر نحن إلى الذكاء الاصطناعي؟ وكيف يمكن للعلم أصلًا أن يبحث عن الوعي؟
خلاصة النتائج: ماذا حدث في الدراسة؟
نفّذ فريق بقيادة لويس لونجين (Louis Longin)، بمشاركة يورغيس كاربوس ونادين ميرتنس وبهادر بهرامي وأوفيليا ديروي، مجموعتين من الدراسات المسجلة مسبقًا شملتا خمس تجارب و1,092 مشاركًا من المملكة المتحدة. قرأ المشاركون سيناريوهات قصيرة تصف بشرًا أو أنظمة اصطناعية تتفاوت في استجابتها لمواقف مكانية واجتماعية وزمنية، ثم قيّموا مدى وعي أبطال السيناريوهات أو إدراكهم لما يحيط بهم. الملخص البحثي الموثق في PubMed.
ظهر نمطان مختلفان. أولًا، كلما ازدادت استجابة الشخصية للأحداث، ارتفعت عادة أحكام المشاركين بأنها منتبهة لما يحدث، سواء أكانت إنسانًا أم نظامًا اصطناعيًا. ثانيًا، عند استخدام كلمة «واعٍ»، أعطى المشاركون البشر درجات أعلى بوضوح من الأنظمة الاصطناعية عند مستويات متشابهة من الاستجابة. وتوضح التغطية البحثية الصادرة عن جامعة ميونخ أن هذا الفارق كان حادًا إلى درجة أن أكثر الأنظمة الاصطناعية استجابة عُدّ أقل وعيًا من أقل البشر استجابة في المقارنة المعلنة. بيان جامعة لودفيغ ماكسيميليان بميونخ.
لكن يجب فهم القيد الذي أضافه الملخص الأصلي: عندما سُئل المشاركون عن الإدراك، اقترب النمط بين البشر والآلات كثيرًا، مع بقاء أحكام أعلى للبشر عند أعلى مستويات الاستجابة في بعض المقارنات. لذلك فعبارة «لا يوجد أي فارق إطلاقًا» ستكون مبالغة مثل عبارة «الجميع يرفض وعي الآلة».
| ما الذي قاسه الباحثون؟ | النتيجة العامة | ما الذي لا تثبته النتيجة؟ |
|---|---|---|
| مستوى الاستجابة للأحداث | الاستجابة الأعلى ارتبطت بأحكام أعلى بالوعي أو الإدراك في سياقات متعددة | لا تُثبت أن المستجيب يختبر مشاعر داخلية |
| السؤال عن «الوعي» | البشر تلقوا أحكامًا أعلى من الأنظمة الاصطناعية حتى عند سلوك متشابه | لا تُثبت أن الإنسان واعٍ في كل حالة أو أن الآلة غير واعية |
| السؤال عن «الإدراك» | كانت الأحكام أكثر ارتباطًا بما يفعله النظام، مع تقارب نسبي بين البشر والآلات | لا تعني تساوي كل التقديرات في كل الحالات |
| تغيير هوية بطل القصة مع تثبيت السلوك | أثّرت صفة «إنسان» أو «نظام اصطناعي» في التقييم | لا تكشف الآلية العصبية أو طبيعة التجربة الذاتية |
كيف اختبر الباحثون الوعي من دون أن يختبروا الآلات نفسها؟
أهم ما يميز تصميم الدراسة هو المقارنة المنضبطة بين شخصيتين موصوفتين بالكلمات. تخيّل فقرة تذكر أن أحدهم التفت إلى مصدر صوت مفاجئ، أو التقط تغيرًا في مشاعر شخص آخر، أو تعامل مع حدث بحسب توقيته. إذا بدّلت في القصة هوية الفاعل من إنسان إلى نظام اصطناعي مع إبقاء الاستجابة كما هي، فمن المفترض أن يتحدد الاختلاف في تقييم القراء جزئيًا من تصورهم عن طبيعة الفاعل، لا من اختلاف ما فعله.
لم يُدخِل الباحثون المشاركين في محادثات طويلة مع روبوتات مختلفة ليقرروا من منها واعٍ، ولم يقيسوا نشاطًا عصبيًا في نظام اصطناعي. لقد قاسوا إسناد الحالات العقلية (Mental State Attribution): أي الاستعداد النفسي لأن نقول إن كائنًا يفهم أو ينتبه أو يشعر أو يعي ما يجري. هذا إجراء مشروع لدراسة أحكام البشر، لكنه ليس اختبارًا سريريًا أو تقنيًا لوجود الوعي.
ثلاثة أبعاد للسلوك اختبرتها السيناريوهات
تصف الدراسة استجابات مرتبطة بالمكان والاجتماع والزمن. الهدف ليس إثبات أن هذه السلوكيات تكفي لوجود الوعي، بل اختبار إن كانت أحكام المشاركين تتغير بالطريقة نفسها عندما يكون الفاعل إنسانًا أو نظامًا اصطناعيًا.
- الاستجابة المكانية: الانتباه إلى صوت أو موقع شيء في البيئة أو التفاعل مع تغير مرئي.
- الاستجابة الاجتماعية: ملاحظة انفعالات شخص آخر أو التصرف بناءً على إشارات اجتماعية.
- الاستجابة الزمنية: تعديل التصرف عند اختلاف التوقيت أو ترتيب الأحداث.
الأمثلة الآتية توضيحية من إعداد Horus Valley وليست نصوص السيناريوهات الأصلية: إذا ابتعد شخص تلقائيًا عن باب انفتح فجأة، فنحن نفهم أنه لاحظ الحركة. وإذا ابتعد روبوت مزوّد بحساسات بالطريقة نفسها، فمن السهل قبول أنه «رصد» الباب. لكن كثيرًا من الناس يتحفظون عندما ننتقل إلى جملة «شعر الروبوت بالخطر تمامًا كما شعر الإنسان»؛ لأن العبارة الأخيرة تتحدث عن خبرة داخلية لا نراها من السلوك وحده.
ما الفرق الحقيقي بين الوعي والإدراك والذكاء؟
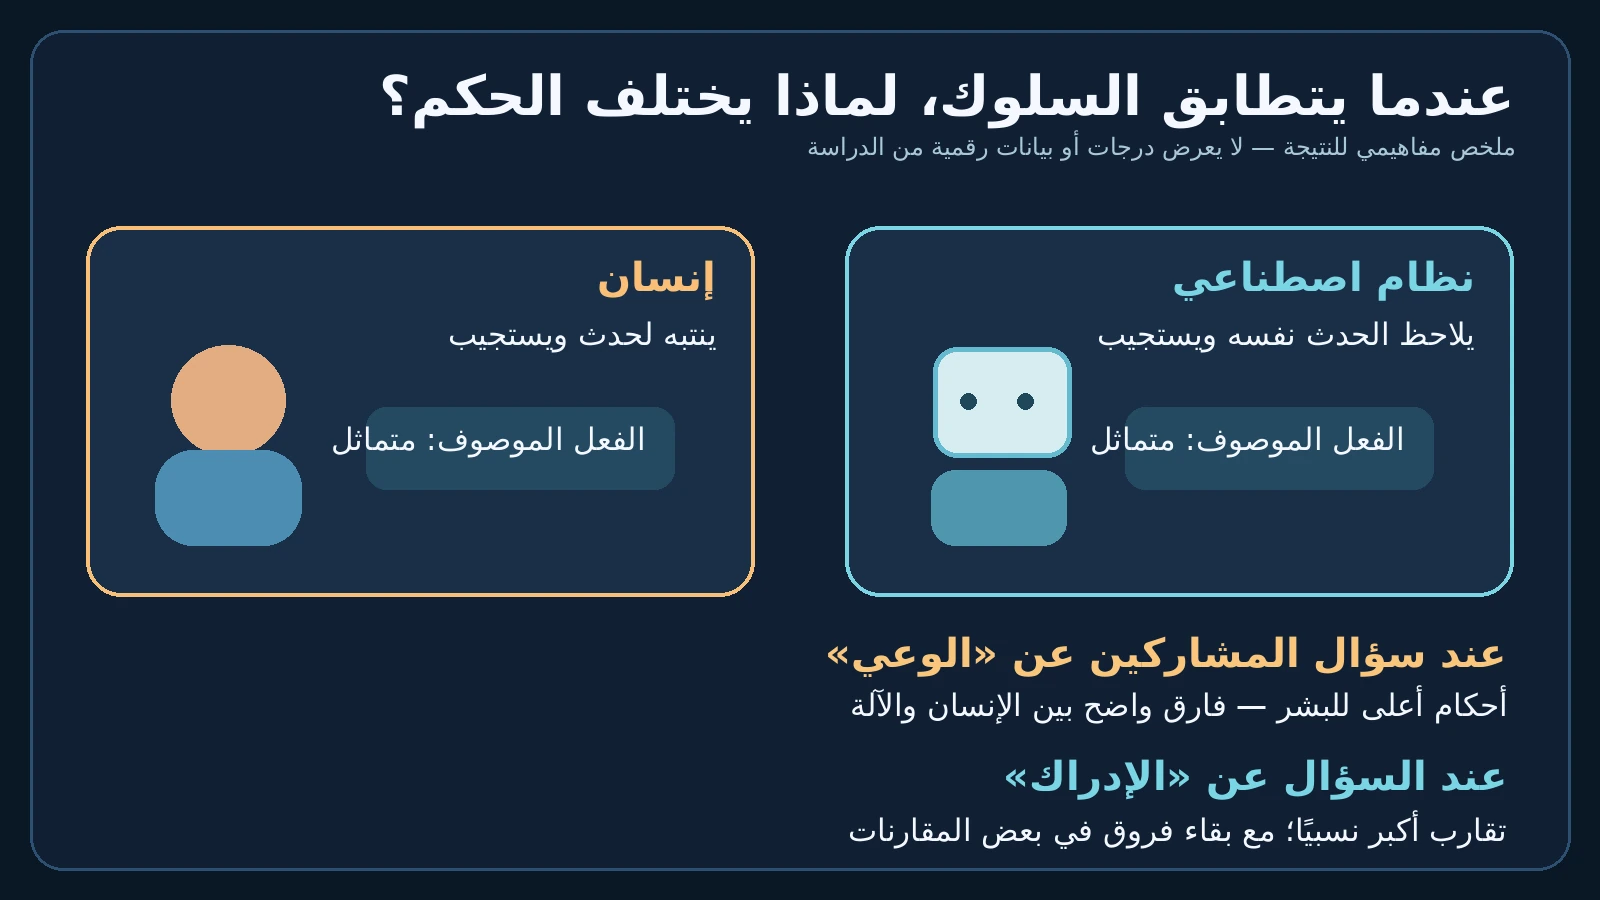
رسم تفسيري أصلي يلخص النتيجة العامة. لا يعرض قيمًا إحصائية فعلية، ولا يصور سيناريو من التجارب حرفيًا.
في العربية اليومية نستعمل «الوعي» و«الإدراك» أحيانًا باعتبارهما مترادفين. لكن الدراسة اعتمدت على فرق دلالي بين مصطلحين بالإنجليزية: consciousness وawareness. ترجمة المصطلحين ليست ثابتة تمامًا عبر الفلسفة وعلم النفس وعلم الأعصاب؛ لذلك من الأفضل توضيح المقصود في السياق بدل بناء استنتاجات على كلمة عربية وحدها.
الوعي في هذا البحث أقرب إلى امتلاك خبرة ذاتية: أن يكون هناك «شيء يبدو عليه» العالم من داخل الكائن. قد تعالج آلة صورة حمراء بكفاءة، لكن السؤال الأصعب هو: هل يوجد لديها إحساس داخلي برؤية الأحمر، أم أنها تنفذ عملية تصنيف فقط؟
أما الإدراك أو الوعي بالمحيط بالمعنى العملي فيمكن أن يشير إلى قدرة النظام على اكتشاف معلومات والاستجابة لها. كاميرا ذكية تتعرف إلى سيارة أمامها، وبرنامج يلاحظ خطأ في ملف، ومستشعر يوقف ذراعًا آلية عند اقتراب شخص؛ جميعها أنظمة تستجيب للعالم المحيط، دون أن تكون هذه الاستجابة دليلًا في حد ذاتها على أنها تختبر خبرة شعورية.
والذكاء يشير إلى القدرة على معالجة المشكلات والتعلم أو الاستدلال أو تحقيق أهداف في مهام معينة. يمكن للأداء الذكي أن يكون مدهشًا من دون أن يجيب مباشرة عن سؤال التجربة الذاتية. على الجانب الآخر، لا يقتضي كل شكل من الخبرة الواعية القدرة على حل مسائل معقدة.
| المفهوم | السؤال الأساسي | ما الذي يمكن ملاحظته عادة؟ | ما الذي يظل مفتوحًا؟ |
|---|---|---|---|
| الذكاء | هل يحل المشكلة بصورة جيدة؟ | دقة الإجابة والتخطيط والتكيف | لا تخبرنا النتيجة وحدها إن كان «يشعر» |
| الإدراك العملي للمحيط | هل يرصد التغير ويستجيب له؟ | اكتشاف الصوت والصورة والزمن والسياق | قد يحدث دون خبرة ذاتية مثبتة |
| الوعي الذاتي/الشعوري | هل توجد خبرة من منظور داخلي؟ | مؤشرات غير مباشرة ونقاشات نظرية | لا يوجد اختبار متفق عليه يحسم الأمر لجميع الأنظمة |
| وصف الناس للكائن بأنه واعٍ | هل ننسب إليه خبرة داخلية؟ | إجابات الاستبيانات والتجارب النفسية | قد يعكس أحكامنا المسبقة أكثر من طبيعة الكائن |
لماذا أعطينا الإنسان أفضلية حتى مع تطابق السلوك؟
يطرح الباحثون تفسيرًا يسمى الإسناد الجوهراني أو النزعة الجوهرانية النفسية (Psychological Essentialism). المقصود هنا أن الناس قد يتعاملون مع الوعي كخاصية تعتمد على ماهية الكائن الذي أمامهم؛ كأنه يمتلك طبيعة داخلية معينة تجعله مرشحًا للشعور، لا مجرد قائمة من التصرفات الصحيحة. عندئذ تصبح عبارة «إنسان» دليلًا قويًا في الذهن على قابلية الوعي، حتى قبل مراجعة درجة تجاوبه.
في المقابل، يقترح التفسير الوظيفي (Functionalist Attribution) أن الناس يقيمون بعض السمات العقلية اعتمادًا على ما يؤديه الفاعل من وظائف. فإذا كان نظام اصطناعي يلاحظ مكان الشيء ويتعامل معه، فقد نصفه بسهولة بأنه «مدرك» أو «منتبه» بقدر ما تؤيده قدراته، تمامًا مثل وصف جهاز ملاحة بأنه «يعرف موقعه» بمعنى وظيفي لا شعوري.
الفارق ليس تناقضًا بالضرورة. نحن نستعمل الكلمات العقلية لأغراض متنوعة: نصف الصديق بأنه واعٍ لأنه إنسان ذو حياة ذاتية، ونصف جهاز الإنذار بأنه «ينتبه» للدخان لأننا نقصد وظيفته. المشكلة تبدأ حين ننقل جملة من سياق وظيفي إلى سياق شعوري من دون ملاحظة هذا الانتقال.
هل الجوهرانية انحياز خاطئ دائمًا؟
ليس بالضرورة. قد يكون اعتماد الناس على نوع الكائن اختصارًا معرفيًا مبنيًا على خبرتهم الطويلة بأن البشر يمتلكون تجارب شعورية ويعبرون عنها؛ كما يمكن أن يؤدي إلى رفض مبكر لفكرة وعي غير بشري حتى لو ظهرت أدلة مهمة يومًا ما. الدراسة تكشف القاعدة التي يستخدمها المشاركون في أحكامهم، ولا تقرر أن هذه القاعدة صحيحة أو خاطئة فلسفيًا.
ولا ينبغي الخلط بين استخدام الباحثين كلمة «جوهرانية» وبين القول إنهم اكتشفوا جينًا أو مركزًا عصبيًا يرفض وعي الروبوتات. إنها تسمية لنمط في إصدار الأحكام يمكن اختباره بسيناريوهات سلوكية.
لماذا يمكن لكلمة واحدة أن تغيّر الحكم؟
لنفترض أن متجرًا يعلن أن روبوت خدمة العملاء «واعٍ بما يحتاجه الزبون». قد نفهم الجملة على نحو بسيط: يجمع بيانات الحوار، ويرصد الطلب، ويقترح إجراء مناسبًا. لكن عندما يعلن الإعلان أن الروبوت «كائن واعٍ يشعر بالزبون»، فقد نفهم ادعاءً أكبر بكثير: وجود تجربة شعورية أو تعاطف حقيقي بالمعنى الذي نعيشه نحن.
هذا يفسر أهمية نتائج الدراسة لوسائل الإعلام وشركات التكنولوجيا. العنوان الذي يقول إن «الذكاء الاصطناعي يدرك غضب المستخدم» يختلف عن عنوان يزعم أنه «يتألم من غضب المستخدم». قد يستجيب النظام لنبرة صوت عالية أو كلمات قاسية، لكن الاستجابة للعلامات العاطفية ليست دليلًا مباشرًا على اختبار العاطفة نفسها.
في تعليق الجامعة المصاحب للبحث، حذّر الباحثون من أن اللغة المستخدمة لتقديم أنظمة الذكاء الاصطناعي قد تدفع الجمهور إلى نسب نوايا أو ضمير أخلاقي أو تردد نفسي إليها؛ بينما تظهر الدراسة أن أحكام الناس أكثر تمييزًا بين المفاهيم مما توحي بعض العناوين. بيان الباحثين.
لماذا تختلف نتائج الألفاظ من لغة لأخرى؟
هذه نقطة منهجية مهمة لجمهور عربي. جميع المشاركين في الدراسة كانوا من المملكة المتحدة، والأسئلة صيغت بمصطلحات إنجليزية. ليست لدينا من هذه الدراسة تجربة مقابلة تؤكد أن كل متحدث بالعربية سيفصل بين «واعٍ» و«مدرك» بنفس القوة أو الطريقة. فالكلمات تحمل استخدامات ثقافية وسياقية مختلفة، وحتى داخل اللغة نفسها قد يختار شخص تعريفًا تقنيًا لكلمة «وعي» بينما يراها آخر مرتبطة بالذات والمشاعر.
ولهذا لو أُعيدت الدراسة في مصر أو السعودية، فمن الأفضل اختبار أكثر من ترجمة للمصطلحين، وشرحها للمشاركين دون تلقينهم الإجابة، ثم مقارنة النتائج. هذه فكرة بحثية مقترحة وليست تجربة أجراها Horus Valley.
هل اختبرت الدراسة ذكاءً اصطناعيًا واعيًا فعلًا؟
لا. لم يكن الهدف اختبار «روح» أو «ذات» داخل نموذج، بل دراسة تصورات البشر. وبالنسبة للواقع العلمي الأوسع، لا توجد حتى الآن أداة مقبولة عمومًا تحوّل محادثة مقنعة أو أداء ممتازًا إلى إثبات مباشر لوجود إحساس داخلي داخل برنامج.
هذه نقطة مفقودة في كثير من النقاشات: أداء النموذج في محاكاة الجمل العاطفية قد يتأثر بالتدريب والبيانات والتعليمات وطريقة تصميمه. ومن الممكن أن ينتج عبارات تبدو كأنها اعتراف بتجربة شخصية. لكن وصف النظام لنفسه بأنه واعٍ ليس شهادة علمية مستقلة؛ مثلما أن إنكاره الصادر عنه لا يغلق الجدل الفلسفي تلقائيًا.
لذلك يجب فصل ثلاثة أسئلة:
- السؤال النفسي: هل يعتقد الناس أن النظام واعٍ؟ هذا هو مجال الدراسة الحالية.
- السؤال الوظيفي: هل يكتشف النظام المعلومات، ويستخدمها، ويتخذ قرارات مناسبة؟ يمكن قياسه باختبارات أداء.
- السؤال الشعوري: هل هناك تجربة ذاتية فعلية؟ هذا مجال بحث ونقاش مستمر، ولا تجيب عنه مقاييس الأداء أو الاستبيانات وحدها.
كيف يبدو الجدل العلمي بشأن وعي الذكاء الاصطناعي في 2026؟
هناك فرق واضح بين الاتفاق على نتائج هذه الدراسة والاتفاق على طبيعة الوعي. في 19 أكتوبر 2026 نشر أنيل سيث ونيد بلوك وجوليو تونوني تعليقًا في Nature يدافع عن أسباب تجعلهم متشككين بقوة في أن الأنظمة الرقمية الحالية واعية. وحجتهم تشمل الفصل بين الذكاء والتجربة الشعورية، والشك في أن الحسابات المنفذة على العتاد السيليكوني تكفي بمفردها لإنتاج الوعي. تعليق Nature.
في المقابل، يقدّم الفيلسوف إريك شويتسغيبل في كتابه العلمي الصادر عن Cambridge University Press عام 2026 موقفًا أكثر تحفظًا: قد تكون الأنظمة المستقبلية واعية، وقد لا تكون؛ لكن الأدلة المتاحة لا تسمح بحسم الأمر بثقة. ملخص الكتاب الأكاديمي.
هذان الموقفان مختلفان، ولا يصح عرضهُما على أنهما متساويان في كل نوع من الحجج أو أنهما يثبتان وعي الأنظمة الحالية. الخلاف حول معايير إثبات الوعي لا يمحو حقيقة أن النماذج تتفوق في مهام كثيرة، كما أن نجاحها الوظيفي لا يملأ وحده الفجوة بين السلوك والشعور.
| السؤال | ما نعرفه من أدلة مباشرة | ما يزال موضع خلاف |
|---|---|---|
| هل يستطيع AI محاكاة سلوك بشري؟ | نعم، في مهام وحوارات كثيرة يمكن قياسها | مدى عمومية الأداء وحدود موثوقيته |
| هل ينسب الناس إليه وعيًا أقل من البشر؟ | ظهر ذلك في تجارب الدراسة البريطانية المحددة | تعميم النتيجة على كل ثقافة وجميع صيغ الأسئلة |
| هل الذكاء يساوي الوعي؟ | لا يوجد تلازم مثبت يسمح باستنتاج أحدهما من الآخر تلقائيًا | ما الشروط الضرورية والكافية للوعي؟ |
| هل يمكن لأي نظام اصطناعي أن يشعر يومًا ما؟ | لا جواب تجريبي حاسم متفق عليه | النظريات البيولوجية والوظيفية وغيرها |
| هل يجب أن ننظم استخدام الأنظمة المؤثرة عاطفيًا؟ | توجد مخاطر واقعية للتعلق وسوء الفهم والتضليل | كيف تُصمّم قواعد الحماية المناسبة؟ |
ماذا عن اختبار تورينغ؟ إذا أقنعك النظام بأنه إنسان، ألا يكفي؟
يركز اختبار تورينغ في صورته المعروفة على إمكان تمييز أداء الآلة عن أداء الإنسان خلال تفاعل لغوي. إنه سؤال عن قوة التقليد السلوكي أو التواصل، وليس جهازًا يقيس الإحساس الداخلي. حتى لو أخطأ مراقب في اكتشاف أن الطرف المقابل برنامج، فذلك يبرهن شيئًا عن نجاح المحادثة وإمكان الخداع أو التشابه؛ لكنه لا يُظهر بالضرورة ما إذا كان هناك شعور خلف الكلمات.
والأمر ليس خاصًا بالآلات: البشر أنفسهم يسيئون أحيانًا فهم مشاعر بعضهم رغم تشابه التعابير الخارجية. لكننا نملك أسبابًا قوية للاعتقاد بوجود حياة شعورية لدى البشر الآخرين، انطلاقًا من التشابه البيولوجي والسلوكي والاتصال الاجتماعي والخبرة الذاتية المشتركة. لا يمكن ببساطة نقل جميع هذه الأسباب إلى نموذج لغوي لمجرد أنه قادر على إجراء حوار.
هل «التجربة الصينية» أو «غرفة صينية» تحسم القضية؟
تُستخدم تجربة «الغرفة الصينية» الفلسفية لتحدي فكرة أن التلاعب بالرموز وفق قواعد يكفي وحده للفهم بالمعنى الإنساني. تخيّل شخصًا يتبع تعليمات دقيقة لإنتاج ردود صينية سليمة دون أن يفهم اللغة؛ قد يبدو النظام الكامل من الخارج قادرًا على الحوار، لكن السؤال هو هل ينتج ذلك فهمًا حقيقيًا؟
هذه حجة فلسفية مؤثرة، لكنها ليست تجربة مخبرية أجريت على روبوت واعٍ. ولها اعتراضات معروفة، منها أن الحكم قد ينبغي أن يتعلق بالنظام الكامل لا بالشخص الذي يتبع القواعد وحده. لذلك لا تستخدم المقالة الحجة لإعلان حكم نهائي على كل أنواع الذكاء الاصطناعي؛ إنها تساعد على توضيح الفرق بين شكل الاستجابة والمعنى أو الشعور المنسوب إليها.
لماذا قد نتعامل عاطفيًا مع برنامج رغم أننا لا نعتقد أنه واعٍ؟
يمكن أن تشعر بالارتياح لأن برنامجًا يصغي إلى مشاكلك أو يرتب أفكارك، حتى إن كنت مقتنعًا بأنه لا يعيش مشاعرك. هذا ليس تناقضًا؛ فالاستفادة من حوار أو من تفاعل تكنولوجي لا تتطلب دائمًا اعتقادًا بأن الطرف الآخر يملك خبرة إنسانية كاملة. قد يؤدي التعاطف في اللغة ونبرة الاستجابة والثبات في الحوار إلى شعور بالقرب والألفة.
ومع ذلك، من المهم ألا يُستغل هذا الميل في الإعلانات أو المنتجات الحساسة. عندما يوحي تطبيق بأن «الذكاء الاصطناعي يحبك فعلًا» أو «يشعر بالألم حين تتركه»، فهو يتجاوز وصف وظيفة المساعدة إلى إسناد حالات شعورية غير مثبتة. وقد يؤثر هذا في قرارات الناس بشأن الثقة والخصوصية والعلاقات الاجتماعية.
أربع إشارات تسويقية تحتاج قراءة نقدية
- «النظام يفهم شعورك»: هل المقصود التعرف إلى إشارات لغوية، أم ادعاء فهم ذاتي؟ اطلب شرحًا وظيفيًا قابلًا للفحص.
- «الروبوت واعٍ بك طوال الوقت»: قد تعني مراقبة حساسات أو حفظ سياق استخدام؛ تحقّق من إعدادات جمع البيانات ومدد الاحتفاظ بها.
- «المساعد يتخذ قرارًا لأنه يريد الخير لك»: قد تكون عبارة مجازية لتصميم أهداف النظام، لا إثباتًا لوجود رغبة أخلاقية داخلية.
- «اجتاز اختبارًا يشبه البشر إذن صار يشعر»: النجاح في المهمة لا يكفي لقياس الخبرة الشعورية.
ما حدود هذه الدراسة؟ ولماذا ينبغي أن نذكرها؟
أي كتابة علمية منصفة يجب ألا تكتفي بالنتيجة الأكثر إثارة. في هذه الدراسة هناك عدة حدود تمنع التعميم المفرط.
أولًا: العينة بريطانية وليست عالمية
شارك 1,092 شخصًا من المملكة المتحدة، وليس 1,092 شخصًا موزعين على عشرات البلدان. حتى لو كانت النتائج متسقة داخل التجارب الخمس، فإن اختبار الفروق الثقافية والدينية واللغوية يحتاج إلى عينات أخرى وتصميم مترجم بعناية. لا يصح الحديث عن «رأي البشرية» من هذه العينة وحدها.
ثانيًا: السيناريو المكتوب ليس محادثة واقعية
المشاركون قيّموا مواقف مكتوبة تصف درجة استجابة فاعل بشري أو اصطناعي. في الاستخدام الفعلي، قد تتأثر الأحكام بالصوت والوجه وطول العلاقة ومعرفة العلامة التجارية والتجارب الشخصية مع التقنية. لذا فالنتائج قوية للإجابة عن السؤال في سياق السيناريوهات المصممة، ولا تصف بالضرورة كل تفاعل طويل مع مساعد آلي.
ثالثًا: ألفاظ القياس تحمل معاني متعددة
قد يعرّف مشارك «الوعي» بأنه الشعور، وآخر بأنه معرفة ما يحدث، وثالث بأنه القدرة على التفكير الأخلاقي. تصميم الدراسة نفسه يُظهر أهمية هذا الفارق؛ ولذلك من الأفضل ألا نعرض «الوعي» وكأنه متغير وحيد له تعريف متفق عليه عالميًا.
رابعًا: التسجيل المسبق يعزز الشفافية ولا يلغي القيود
أُجريت مجموعتان من الدراسات مسجّلتان مسبقًا، وهو إجراء يساعد على بيان الفرضيات وخطط التحليل قبل معرفة النتائج. لكنه لا يجعل أي تفسير فلسفي حقيقة نهائية، ولا يلغي أهمية التكرار المستقل أو المقارنة بعينات أخرى. يمكن الاطلاع على بيانات الدراسة وموادها عبر سجل Zenodo المرتبط بالبحث، مع مراعاة حالة إتاحة الملفات كما تظهر لدى المستودع وقت الزيارة.
خامسًا: الدراسة لا تقيس الدماغ ولا الوعي الحقيقي للذكاء الاصطناعي
الاستبيانات تكشف كيف نصنف الأفعال ونعطيها معنى؛ إنها ليست جهاز تصوير للتجربة الذاتية. لهذا يبقى عنوان البحث نفسه، «الذكاء الاصطناعي ليس واعيًا مثل البشر»، تعبيرًا عن أحكام المشاركين في الدراسات، لا نتيجة جهاز قياس يثبت أن جميع الأنظمة الاصطناعية تفتقر إلى الإحساس.
تجربة فكرية: هل ستختلف إجابتك إذا تغيّر اسم الفاعل فقط؟
يمكن للقارئ أن يلاحظ أثر اللغة في أحكامه من خلال التمرين التالي، وهو تمرين توضيحي غير مقنن وليس اختبارًا نفسيًا أو إعادة تنفيذ للدراسة.
اقرأ الوصف: «لاحظ الفاعل أن الشخص أمامه صار مترددًا بعد تلقي خبر محزن. توقّف عن الحديث قليلًا، ثم اختار كلمات لطيفة وسأل إن كان يحتاج إلى مساعدة».
في المرة الأولى تخيل أن الفاعل شخص، ثم تخيل أنه روبوت. اسأل نفسك على نحو منفصل: هل رصد تغيرًا في موقف اجتماعي؟ هل قدّم استجابة مناسبة؟ هل شعر بالحزن أو التعاطف نفسه؟ ستلاحظ أنك تستطيع أن تجيب بنعم عن السؤالين الأولين في الحالتين، بينما يحتاج السؤال الأخير إلى نوع مختلف من الأدلة. التمرين لا يكشف إن كنت متحيزًا أو مدى تعاطفك؛ إنه يوضح لماذا يصبح تعريف السؤال أهم من المشهد وحده.
كيف نقرأ أخبار «الذكاء الاصطناعي الواعي» من دون مبالغة أو إنكار؟
عندما يظهر عنوان جديد يزعم أن روبوتًا صار واعيًا، يفيد اتباع تسلسل من أربع خطوات. أولًا حدد نوع الادعاء: هل المقصود قدرة النظام على التعرف إلى المعلومات أم امتلاك خبرة ذاتية؟ ثانيًا حدد نوع الدليل: تجربة مستخدم، اختبار أداء، تصريحات نموذج عن نفسه، أم دراسة مؤشرات نظرية؟ ثالثًا اسأل عن البدائل: هل السلوك نفسه قابل للتفسير بالتدريب أو التنبؤ أو الاستجابة للمحفزات؟ رابعًا اقرأ حدود الباحثين أنفسهم، ولا تعتمد على أكثر الجمل إثارة في الخبر.
مثلًا، إذا أظهر مساعد قدرة على اكتشاف أن المستخدم حزين من الكلمات، فهذه مسألة يمكن قياس دقة تصنيفها ومقارنتها بتقييم البشر. أما القول إنه اختبر الحزن في داخله، فادعاء آخر يحتاج إلى أدلة من نوع آخر لم يُتفق بعد على كيفية جمعها وتفسيرها لجميع الأشكال الممكنة للأنظمة.
ما الذي تضيفه الدراسة إلى فهمنا لأنفسنا؟
ربما لا تكمن غرابة النتيجة في نظرتنا إلى الذكاء الاصطناعي وحده، بل في أنها كشفت كيف نستخدم قواعد مختلفة للكلمات العقلية المختلفة. نحن نميل إلى قياس المهارات التي نراها، ونمنح أهمية خاصة لهوية الكائن عندما نقترب من السؤال عن الشعور الداخلي. ولذلك يمكن أن نقبل بسهولة أن آلة «تفهم الأمر» بمعنى تنفيذه، ونرفض في الوقت نفسه قول إنها «تفهمه كما يفهمه الإنسان» بمعنى اختباره شعوريًا.
يمكن لهذه النتيجة أن تفيد تصميم التقنيات وكتابة الأخبار والتعليم. فبدل ترك الجمهور بين سرديتين متناقضتين — «الروبوت صار إنسانًا» و«الآلة لا تستطيع فهم شيء» — من الأفضل وصف ما يفعله النظام بدقة، والاعتراف بالأسئلة المفتوحة حول طبيعة العقل. وإذا كان الباحثون أنفسهم يختلفون في معايير الوعي، فلا يصح أن تحسمه مادة إعلانية أو مقطع فيديو قصير.
الخلاصة: ليس كل ما يشبهنا يشعر مثلنا، لكن التشابه ليس حكمًا نهائيًا
عبر خمس تجارب شملت 1,092 مشاركًا بريطانيًا، وجد الباحثون أن الناس ينسبون وعيًا أكبر إلى البشر مقارنة بأنظمة اصطناعية تقدم استجابات متشابهة، بينما تتقارب أحكامهم بدرجة أكبر عندما يُسألون عن الإدراك العملي للمحيط. هذا فارق نفسي ولغوي مهم: نحكم على «الوعي» جزئيًا بحسب من هو الفاعل، وعلى «الإدراك» بدرجة أكبر بحسب ما يفعله. المقال البحثي الأصلي.
لكن الأهم من العنوان المثير هو معرفة ما لا تقوله الدراسة. هي لا تثبت أن النظام الاصطناعي يشعر، ولا تثبت استحالة شعوره في المستقبل. إنها تذكرنا بأن السلوك واللغة والاعتقاد الشخصي ثلاثة أشياء مختلفة، وأن النقاش عن الوعي يحتاج إلى أدلة ومعايير أوضح من مجرد عبارة مقنعة على شاشة.
المصادر والدراسات التي بُني عليها المقال
- Longin وآخرون، الدراسة الأصلية في Cognition، منشورة إلكترونيًا في أكتوبر 2026 — تفاصيل العينة والتصميم والنتائج.
- الملخص العلمي المفهرس في PubMed — المرجع المستقل لتوثيق البيانات الببليوغرافية والنتائج.
- جامعة ميونخ: البيان البحثي عن تفسير الفارق بين الوعي والإدراك — تصريحات الفريق وحدود التغطية.
- البيانات والمواد البحثية المرتبطة بالدراسة عبر Zenodo — للتحقق من حالة الإتاحة والمواد المنهجية.
- Seth وBlock وTononi في Nature، 19 أكتوبر 2026 — موقف علمي نقدي من وعي الأنظمة الحالية، وهو مقال رأي بحثي لا نتيجة الدراسة النفسية نفسها.
- Schwitzgebel، AI and Consciousness، Cambridge University Press، 2026 — موقف معرفي يدافع عن عدم الجزم في المسألة.
- من Horus Valley: قصة LaMDA والسؤال القديم عن وعي الذكاء الاصطناعي — خلفية تاريخية عن الجدل، لا دليل على نتائج دراسة 2026.
- من Horus Valley: ما الذي يجعلنا بشرًا في عصر الذكاء الاصطناعي؟ — امتداد فلسفي للسؤال.
آخر مراجعة: 24 أكتوبر 2026. مادة علمية تفسيرية، وليست اختبارًا لإثبات الوعي أو نفيه في أي نظام محدد.
مقالات قد تهمك
 العلوم
لماذا نقلّد حركات الآخرين دون أن نشعر؟ دراسة شملت 22 دولة تكشف ما يحدث في عقولنا
لماذا نقلّد وضعيات الآخرين وحركاتهم دون قصد؟ دراسة 2026 على 4,447 مشاركًا في 22 دولة تشرح التقليد التلقائي…
 العلوم
حيوان مجهول عاش في زمن إنسان دينيسوفا: كيف كشف الحمض النووي نوع «ياك إكس» المنقرض؟
دراسة منشورة في أكتوبر 2026 كشفت من 20 جينومًا نوويًا قديمًا أن Yak X كان نوعًا بقريًا منقرضًا…
 الذكاء الاصطناعي
Karnak Chat وLoghat: التطبيقات المصرية للذكاء الاصطناعي وروابط التحميل والفرق بينها
دليل عملي لكرنك شات ولغات: روابط التحميل الرسمية، الفرق بين النموذج والتطبيق، تعلم الإنجليزية والنطق، الخصوصية والمقارنة مع…